
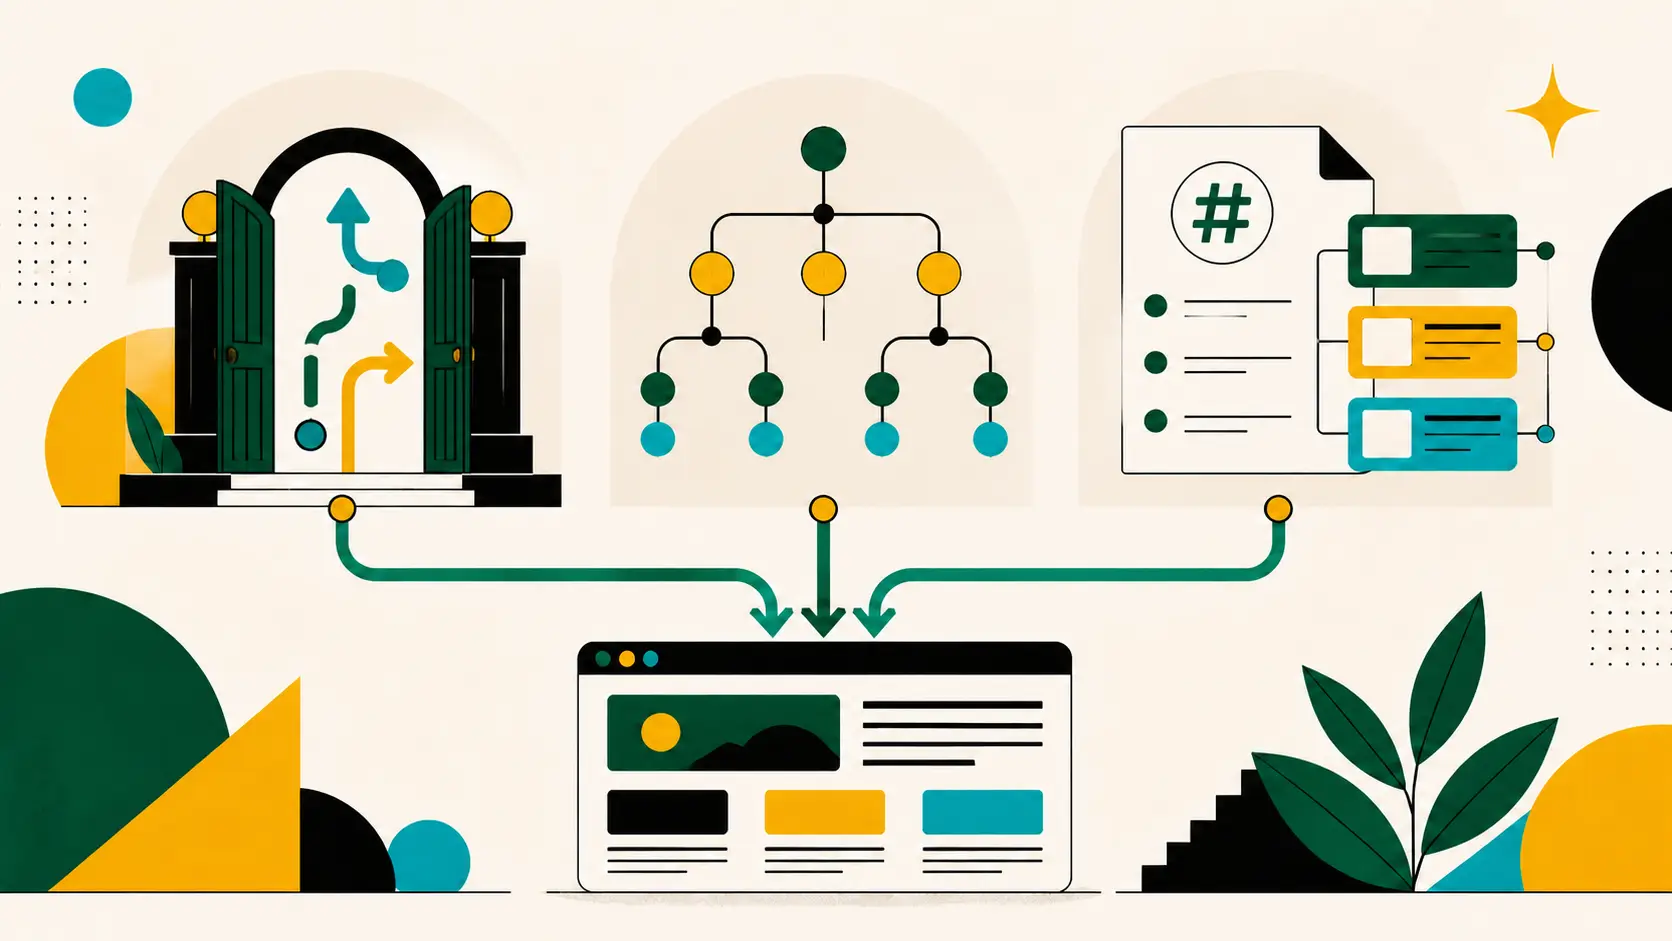
Resposta curta: use robots.txt para “o crawler pode buscar?”, sitemap.xml para “quais URLs importantes existem?” e llms.txt para “quais documentos ajudam a entender este site e por quê?”.
COMPARAÇÃO EM 30 SEGUNDOS
| Arquivo | Trabalho | Público | Não garante |
|---|---|---|---|
| robots.txt | Regras de acesso para crawlers | Robôs identificados | Privacidade ou remoção do índice |
| sitemap.xml | Descoberta de URLs importantes | Mecanismos de busca | Crawl ou indexação |
| llms.txt | Contexto e seleção editorial | Agentes compatíveis | Adoção, citação ou ranking |
Controle
ROBOTS
Declara o que crawlers compatíveis podem buscar.
Descoberta
SITEMAP
Lista URLs que o site considera importantes.
Contexto
LLMS
Explica quais documentos consultar e por quê.
ROBOTS.TXT: REGRAS DE RASTREAMENTO
O robots.txt fica na raiz do domínio e segue o Robots Exclusion Protocol, padronizado no RFC 9309. Ele declara regras para agentes identificados.
User-agent: *
Disallow: /carrinho/
Disallow: /busca-interna/

Sitemap: https://exemplo.com.br/sitemap.xml
Segundo o Google Search Central, seu objetivo principal é gerenciar tráfego de crawlers. Ele não é um mecanismo de segurança.
SITEMAP.XML: DESCOBERTA DE URLS
O sitemap é um catálogo estruturado de páginas, imagens, vídeos ou notícias que o site considera importantes. Ele pode informar URL canônica, última atualização e relações com versões em outros idiomas.
<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <url>
    <loc>https://exemplo.com.br/produtos/cafe-especial</loc>
    <lastmod>2026-08-10</lastmod>
  </url>
</urlset>
O Google explica que sitemaps ajudam a rastrear sites com mais eficiência, sobretudo sites grandes, novos ou com mídia especializada. Enviar uma URL, porém, não garante que ela será rastreada ou indexada.
Prefira URLs canônicas que você deseja ver nos resultados. Evite páginas redirecionadas, duplicadas, privadas, bloqueadas ou marcadas para não indexar.
LLMS.TXT: CONTEXTO E CURADORIA
O llms.txt também usa um endereço previsível, mas seu trabalho é orientar. A proposta aberta descreve um arquivo Markdown pequeno com resumo, instruções e listas comentadas.
# Loja Exemplo

> Cafés brasileiros de pequenos produtores, com torra semanal.

## Compra e atendimento

- [Catálogo](https://exemplo.com.br/markdown/catalogo.md): origem, torra e preço
- [Assinaturas](https://exemplo.com.br/markdown/assinaturas.md): planos e cancelamento
- [Entregas](https://exemplo.com.br/markdown/entregas.md): regiões e prazos
As descrições dão significado aos links. Em vez de listar centenas de URLs, o arquivo seleciona o que um consumidor compatível deveria abrir para uma tarefa.
OS TRÊS TRABALHANDO JUNTOS
/robots.txt      regras para crawlers
/sitemap.xml     URLs HTML importantes para descoberta
/llms.txt        índice curado para agentes compatíveis
/llms-full.txt   conteúdo consolidado opcional
/markdown/*.md representações textuais das páginas- Acesso: o crawler consulta
robots.txte respeita as regras aplicáveis. - Descoberta: o mecanismo usa links e
sitemap.xmlpara encontrar URLs. - Contexto: uma ferramenta compatível consulta
llms.txt, escolhe documentos e busca o detalhe.
Nenhum arquivo atravessa autenticação. Nenhum transforma conteúdo ruim em boa resposta. Todos dependem de páginas corretas, públicas quando necessário e bem mantidas.
CINCO ERROS COMUNS
1. Guardar segredos no robots.txt
O arquivo é público e pode revelar o nome dos caminhos bloqueados.
2. Tratar sitemap como garantia
Ele favorece descoberta, mas não ordena crawl nem indexação.
3. Copiar o sitemap no llms.txt
Isso remove a curadoria que torna o índice útil.
4. Duplicar Markdown sem relação
Sinalize representações alternativas e preserve a página humana canônica.
5. Atualizar um arquivo e esquecer os outros
Valide links e regenere índices quando páginas, URLs, preços ou políticas mudarem.
QUAL DELES O SEU SITE PRECISA?
- Quase todo site público: um
robots.txtcorreto, ainda que permita os caminhos públicos. - Sites grandes, novos ou com mídia: um
sitemap.xmltende a ajudar a descoberta. - Sites com documentação ou informação para agentes: um
llms.txtpode reduzir o caminho para consumidores compatíveis. - Conteúdo privado: autenticação e autorização; nenhum desses arquivos substitui segurança.
CHECKLIST ANTES DE PUBLICAR
- Confirme que
robots.txtestá no host e protocolo corretos. - Não bloqueie recursos necessários por acidente.
- Liste no sitemap somente URLs canônicas e indexáveis.
- Use datas de modificação verdadeiras.
- Mantenha o
llms.txtcurto, descrito e baseado em URLs estáveis. - Não coloque informação privada em arquivos públicos.
- Valide todos os links após cada publicação.
- Regere Markdown e índices quando a página humana mudar.
FONTES PRIMÁRIAS
- Proposta /llms.txt, versão 2
- RFC 9309 — Robots Exclusion Protocol
- Google: introdução ao robots.txt
- Google: visão geral de sitemaps
- Sitemaps.org: protocolo XML
- Google: otimização para recursos generativos
Fontes verificadas em 15 de agosto de 2026.